Moria
31,102 पदों में से हर एक के लिए Moria पहले ही निकाल चुका है कि कौन-से दूसरे पाठ उससे जुड़े हैं, पाँच ऐसी विधियों से जो एक-दूसरे पर निर्भर नहीं हैं — और वह आपको पद-दर-पद दिखाता है कि हर संबंध वास्तव में किस चीज़ से बना है।
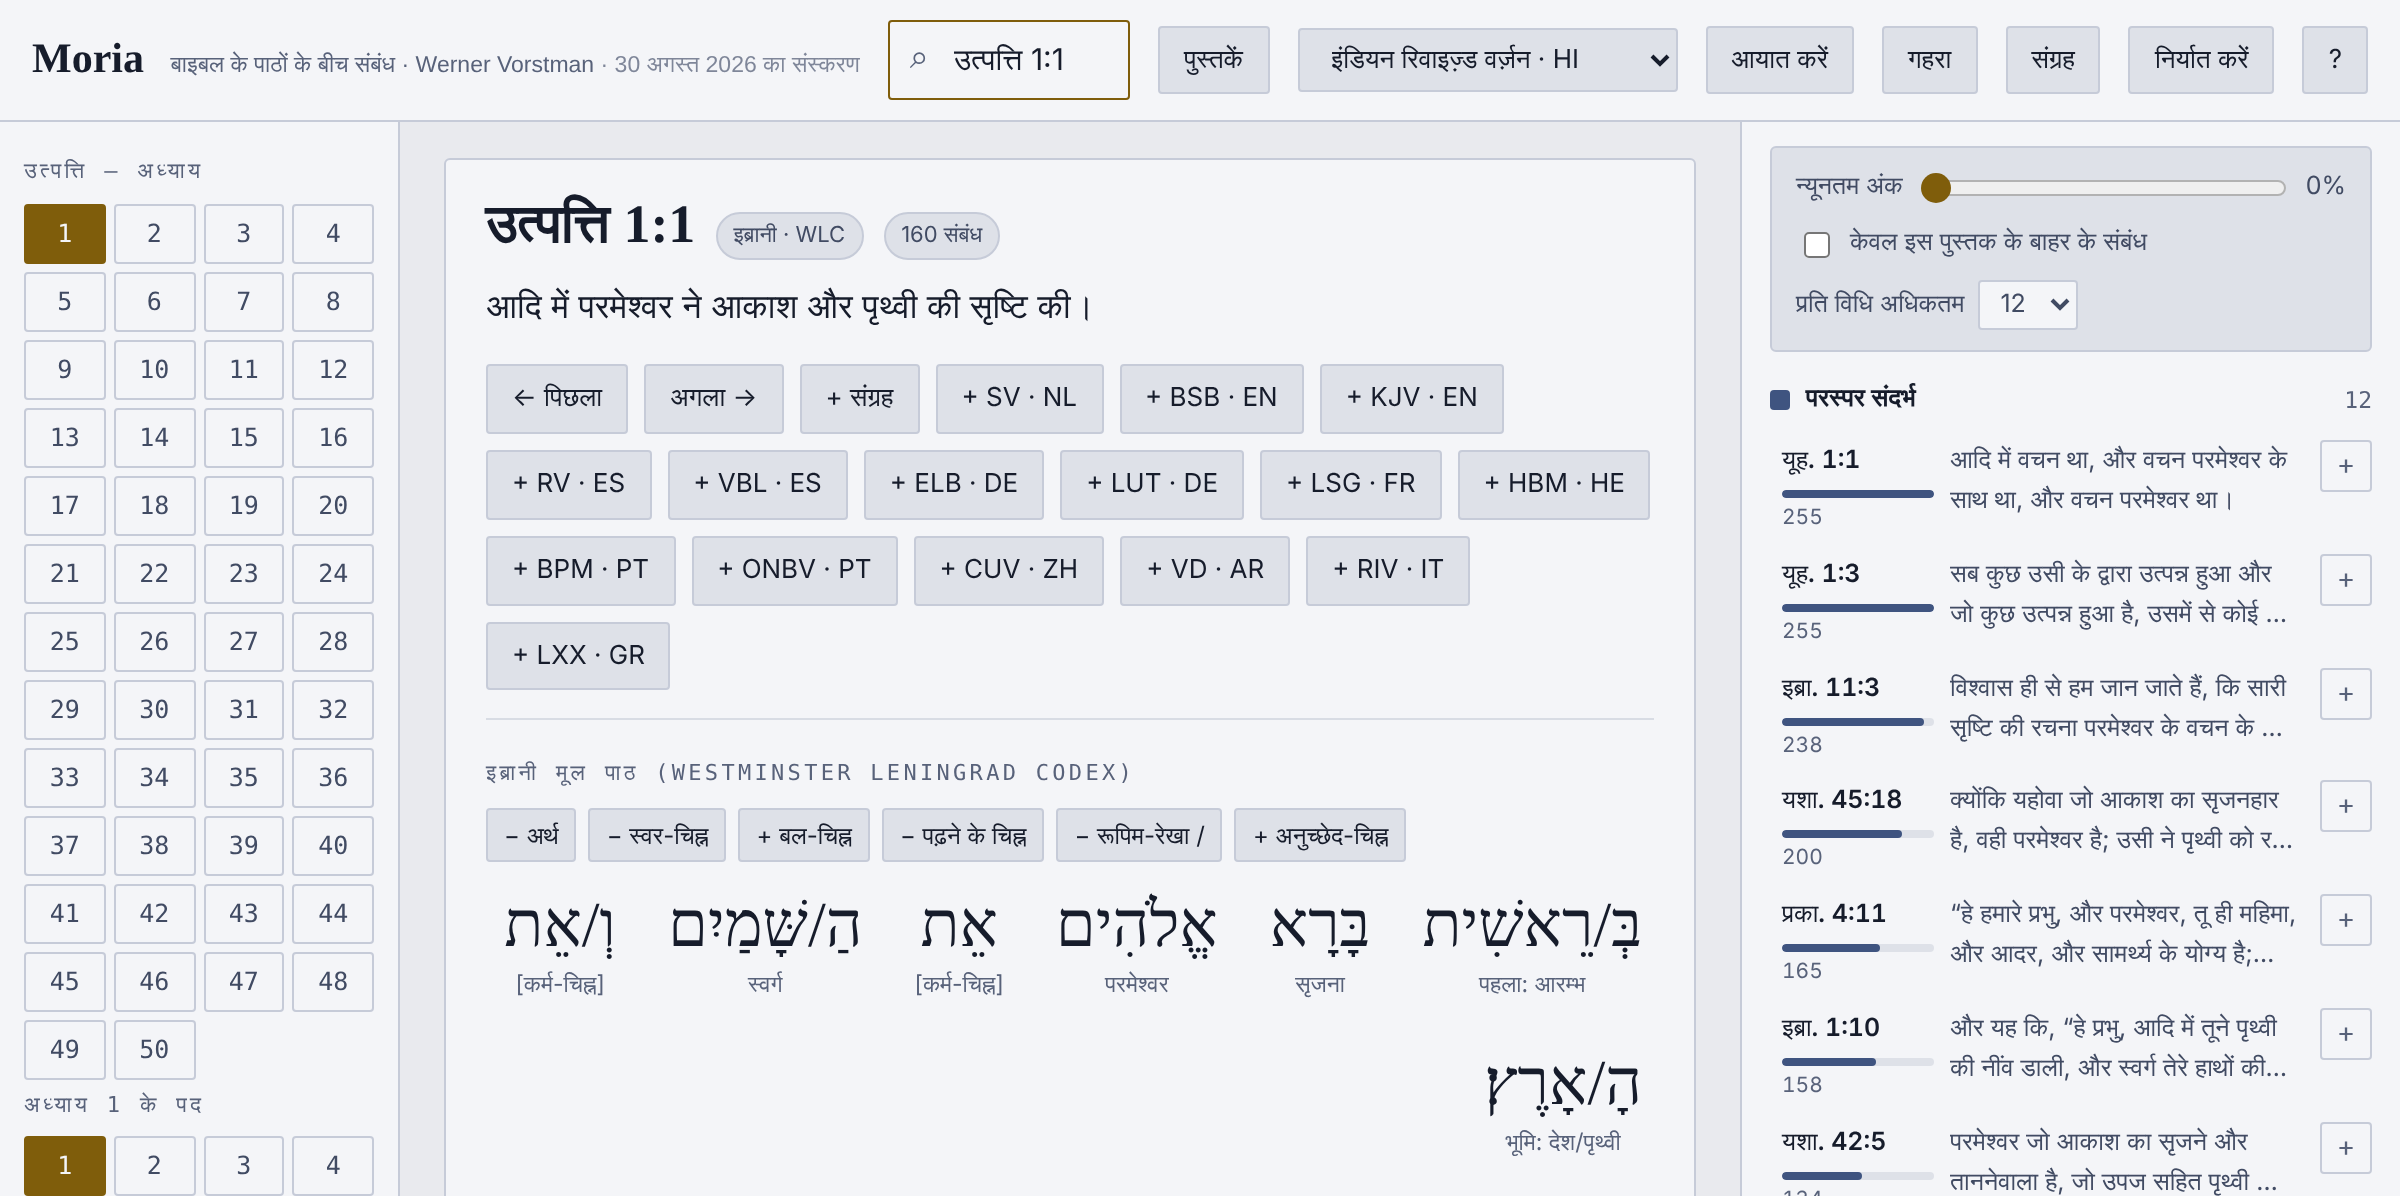
इसमें क्या है
मूल भाषाएँ। पुराने नियम की इब्रानी (Westminster Leningrad Codex), नए नियम की यूनानी (MorphGNT/SBLGNT) और यूनानी पुराना नियम (सेप्टुआजिंट, Swete का संस्करण)। पहले दो का शब्द-दर-शब्द विश्लेषण किया गया है — 444,000 शब्द, हर एक अपने मूल रूप (लेम्मा), अपने शब्द-भेद और अपने रूप-परिवर्तन के साथ।
पढ़ने के लिए पंद्रह अनुवाद:
| अनुवाद | भाषा और देश | वर्ष | संक्षेप में |
|---|---|---|---|
| Statenvertaling | डच, नीदरलैंड | 1637 | मूल हाशिया-टिप्पणियों और हर शब्द पर Strong संख्या के साथ विस्तारित संस्करण |
| King James Version | अंग्रेज़ी, इंग्लैंड | 1611 | क्लासिक अंग्रेज़ी बाइबल |
| Berean Standard Bible | अंग्रेज़ी, संयुक्त राज्य अमेरिका | 2023 | मूल पाठ से आधुनिक अनुवाद |
| Reina-Valera | स्पेनिश, स्पेन | 1909 | क्लासिक स्पेनिश बाइबल |
| Versión Biblia Libre | स्पेनिश | 2018 | इब्रानी और यूनानी से आधुनिक अनुवाद (Gallagher और Barrios de Avila, CC BY-SA 4.0) |
| Elberfelder | जर्मन, जर्मनी | 1905 | एक बहुत शाब्दिक अनुवाद |
| Lutherbibel | जर्मन, जर्मनी | 1912 | लूथर का अनुवाद, 1912 के संशोधन में |
| Louis Segond | फ़्रेंच, स्विट्ज़रलैंड | 1910 | सबसे अधिक प्रयुक्त प्रोटेस्टेंट फ़्रेंच बाइबल |
| Bíblia Portuguesa Mundial | पुर्तगाली, ब्राज़ील | आधुनिक | World English Bible पर आधारित; अभी एक प्रारूप |
| Nova Bíblia Viva | पुर्तगाली, ब्राज़ील | 2007 | एक स्वतंत्र अनुवाद, भावानुवाद के निकट (Biblica Open, CC BY-SA 4.0) |
| Riveduta 1927 | इतालवी, इटली | 1927 | Giovanni Luzzi का क्लासिक प्रोटेस्टेंट अनुवाद |
| Modern Hebrew Bible | इब्रानी, इस्राएल | आधुनिक | पुराना नियम बिना स्वर-चिह्नों के इब्रानी पाठ में, नया नियम Delitzsch की शैली के इब्रानी अनुवाद में |
| 新标点和合本 (Chinese Union Version) | चीनी (सरलीकृत), चीन | 1919 | मानक चीनी बाइबल, यहाँ आधुनिक विराम-चिह्नों के साथ |
| Van Dyck | अरबी, लेबनान | 1865 | क्लासिक अरबी बाइबल, स्वर-चिह्नों के साथ |
| Indian Revised Version (IRV) | हिन्दी, भारत | 2019 | आधुनिक, काफ़ी शाब्दिक अनुवाद (Bridge Connectivity Solutions, CC BY-SA 4.0) |
हर अनुवाद के अधिकार और संस्करण स्रोतों के पन्ने पर दिए गए हैं।
सेप्टुआजिंट, संरेखित। यूनानी पुराने नियम का Swete संस्करण, सामान्य पद-क्रमांकन के सामने रखा हुआ — और पढ़ने के पाठों में से एक के रूप में King James और बाकी के साथ खोला जा सकता है। कौन-सा यूनानी पद किस सामान्य पद से मेल खाता है, यह हाथ से लिखी कोई तालिका नहीं है: यह स्वयं पाठ से निकाला गया है। व्यक्तिवाचक नाम अनुवाद के बाद भी पहचाने जा सकते हैं — Ἰσραήλ के पास Yisraél — और हर पद की लंबाई के साथ मिलकर यह इतना काफ़ी है कि पुस्तक-दर-पुस्तक गणना की जा सके कि कौन-सा पद किससे मेल खाता है, बिना क्रम के कभी पीछे जाए। 34 ज्ञात जाँच-बिंदुओं पर यह 33 बार सही निकलता है।
एक नक्शा, साथ-साथ रखे सुसमाचार, और एक शब्द-अनुक्रमणिका। नक्शा बाइबल के स्थानों को Tyndale House के TIPNR के अनुसार उनके निर्देशांकों पर, Natural Earth की सरलीकृत तटरेखा के ऊपर रखता है। चारों सुसमाचार साथ-साथ खड़े हैं, हर पद उस पद के सामने जो बाकी तीन में उसके सबसे निकट है। और व्याकरणिक विश्लेषण खोजा जा सकता है, ताकि שׁמע की सभी आज्ञार्थक क्रियाएँ एक दोपहर का काम नहीं, बल्कि एक पंक्ति की खोज हो।
एक संग्रह जो आपका अपना है। पढ़ते समय इकट्ठा किए गए पद, हर एक एक टिप्पणी के साथ, आपके काम के पास एक छोटी JSON फ़ाइल के रूप में सहेजे जाते हैं — जान-बूझकर एक फ़ाइल, ब्राउज़र का भंडारण नहीं, ताकि ब्राउज़र के सफ़ाई करने पर कुछ ग़ायब न हो। इसे Word और Markdown में निर्यात किया जा सकता है।
पाँच विधियाँ, और हर एक क्या दिखा सकती है और क्या नहीं
अधिकांश अध्ययन-बाइबल आपको परस्पर संदर्भों का एक स्तंभ थमा देती हैं, और यह कोई विवरण नहीं देतीं कि वे कहाँ से आए। Moria इसका उल्टा करता है: वह हर पद के लिए पाँच प्रकार के संबंध दर्ज करता है और हर एक के लिए दिखाता है कि वह संबंध किस पर टिका है। ये पाँचों जान-बूझकर एक-दूसरे से अलग हैं: जहाँ उनमें से कई स्वतंत्र रूप से पाठों की एक ही जोड़ी पर पहुँचती हैं, वहाँ उस सहमति का अर्थ है। जहाँ केवल एक पहुँचती है, वहाँ प्रमाण का प्रकार मायने रखता है, और उसका नाम बताया जाता है।
आप कौन-सा अनुवाद पढ़ते हैं, इससे कोई अंक नहीं बदलता। Moria में आप स्वयं चुनते हैं कि कौन-सा बाइबल अनुवाद पढ़ें; इससे केवल यह तय होता है कि आप कौन-सा पाठ देखते हैं। संबंधों की गणना पहले से की गई है, और हर संबंध बताता है कि उसे किस विधि ने पाया। तीन विधियाँ किसी भी अनुवाद से स्वतंत्र रूप से काम करती हैं: वे स्वयं इब्रानी और यूनानी शब्दों की, या नए नियम की सेप्टुआजिंट से, तुलना करती हैं, या वे एक क्लासिक संदर्भ-ग्रंथ (मुख्यतः Treasury of Scripture Knowledge) से आती हैं, जिन्हें openbible.info के उपयोगकर्ताओं के वोटों से अंक दिए गए हैं। दो विधियाँ अनुवाद में खोजती हैं: अनुवाद के माध्यम से उद्धरण Statenvertaling में खोजती है, और विषयगत समानता Statenvertaling और King James में एक साथ। इसलिए इन दोनों के साथ जो सामने आता है, वह आंशिक रूप से अनुवादकों के शब्द-चयन पर निर्भर करता है। नीचे की तालिका बताती है कि हर विधि किस पर टिकी है।
| विधि | यह किस पर टिकी है | यह क्या पाती है |
|---|---|---|
| परस्पर संदर्भ | openbible.info का डेटासेट (CC-BY): एक पद से दूसरे पद तक लगभग 700,000 संदर्भ, वोट-अंकों के साथ, जो अधिकांशतः Treasury of Scripture Knowledge से लिए गए हैं। व्याख्या की एक परंपरा, पाठ का माप नहीं — और एकमात्र विधि जो शब्द-स्तर पर कोई प्रमाण नहीं दिखाती, क्योंकि दिखाने को कुछ है ही नहीं। | क्लासिक संदर्भ, इस आधार पर तौले हुए कि कितने पाठकों ने उनकी पुष्टि की है। |
| मूल भाषा में समानता | Westminster Leningrad Codex और MorphGNT/SBLGNT से मूल रूप (लेम्मा) और Strong संख्याएँ; एकल शब्दों और शब्द-जोड़ों पर tf-idf। इब्रानी और यूनानी के बीच नहीं पहुँच सकती; उसके लिए सेप्टुआजिंट का पुल है। | एक ही भाषा के भीतर समानांतर अंश और शब्दशः उधार — 2 राजाओं 18 के सामने यशायाह 36। |
| सेप्टुआजिंट के माध्यम से उद्धरण | सेप्टुआजिंट पुराने नियम का प्राचीन यूनानी अनुवाद है, जिसे नया नियम अक्सर उद्धृत करता है। नए नियम के हर पद की तुलना उस यूनानी पाठ (Swete) से शब्द-रूपों, शब्द-जोड़ों और दुर्लभ शब्द-शृंखलाओं पर की जाती है। वहाँ चुप रहती है जहाँ नया नियम किसी दूसरे यूनानी पाठ का, या इब्रानी का, अनुसरण करता है। | नए नियम में पुराने नियम के उद्धरण, मूल भाषा के स्तर पर — बीच में किसी अनुवाद के बिना। |
| अनुवाद के माध्यम से उद्धरण | पदों के बीच साझा, चार सार्थक शब्दों के दुर्लभ वाक्यांश, उनकी दुर्लभता के अनुसार तौले हुए। एक अनुवाद से होकर चलती है, इसलिए उसके शब्द आंशिक रूप से तय करते हैं कि क्या सामने आता है। | पूरे धर्मशास्त्र-संग्रह में उद्धरण और संकेत, वहाँ भी जहाँ यूनानी अलग है। |
| विषयगत समानता | दो अनुवादों पर एक साथ 300 आयामों में अव्यक्त अर्थ-विश्लेषण (latent semantic analysis), सीधी शब्द-समानता के साथ मिलाकर। सांख्यिकीय, व्याख्यात्मक नहीं। हर परिणाम को स्वयं परखिए। | एक ही विषय के पाठ जिनमें वही शब्द साझा नहीं हैं। |
इन्हें अलग रखने का उद्देश्य यह है कि वे अलग-अलग ढंग से चूकती हैं। एक सांख्यिकीय विधि शब्दावली की ओर बहक जाती है; संदर्भों की एक पारंपरिक सूची अपने संकलनकर्ताओं की मान्यताएँ साथ लिए चलती है; उद्धरणों की खोज केवल वही पाती है जो उद्धृत किया गया था। साथ पढ़ने पर, और उनके प्रमाण दिखाई देने पर, वे आपको यह देखने देती हैं कि आप किस प्रकार का दावा देख रहे हैं। हर विधि विस्तार से कैसे काम करती है →
इसे क्या अलग बनाता है
हर संबंध अपने प्रमाण के साथ आता है, जिसकी दोनों पदों के बीच तुरंत फिर से गणना की जाती है, ठीक उसी शब्द-विभाजन और उन्हीं निरर्थक-शब्द सूचियों के साथ जिनसे स्वयं विश्लेषण हुआ — नहीं तो चिह्नांकन कुछ और दिखाता, न कि वह जिससे अंक बना।
सेप्टुआजिंट के माध्यम से उद्धरण के लिए वह प्रमाण साझा यूनानी शृंखला है: भजन संहिता 110:1 और इब्रानियों 1:13 में, Κάθου … δεξιῶν … ἕως … ἐχθρούς … ὑποπόδιον … ποδῶν। मूल भाषा में समानता के लिए यह वे मूल रूप हैं जो दोनों पदों में साझा हैं, दुर्लभता के क्रम में, ताकि अलग पहचान देने वाला शब्द पहले आए, न कि उपपद। विषयगत समानता के लिए यह साझा सार्थक शब्द हैं, जो पाठ में चिह्नित किए जाते हैं।
और क्लासिक परस्पर संदर्भों के लिए कुछ नहीं है — और यही बात है। वे पाठकों से विरासत में मिले निर्णय हैं, पाठ के माप नहीं। इस कारण उनका मूल्य कम नहीं होता, पर वे किसी और चीज़ पर टिके हैं, और वह अंतर दिखाई देना चाहिए।
यह इस तरह क्यों बनाया गया है
एक फ़ाइल, कोई सर्वर नहीं। Moria का न कोई बैक-एंड है, न खाता, न आँकड़े इकट्ठा करना, न नेटवर्क कॉल। सब कुछ फ़ाइल के भीतर है। यह आंशिक रूप से गोपनीयता की बात है — कोई नहीं देख सकता कि आप क्या खोजते हैं, क्योंकि उस जानकारी के जाने की कोई जगह नहीं है — और आंशिक रूप से टिकाऊपन की। जो अध्ययन-उपकरण किसी सर्वर पर निर्भर है, वह समाप्ति-तिथि वाला अध्ययन-उपकरण है। फ़ाइल सहेज लीजिए, और वह दस वर्ष बाद भी खुलेगी।
अधिकार से पहले प्रमाण। कोई भी प्रणाली जुड़े हुए पदों की सूची बना सकती है। महत्वपूर्ण प्रश्न यह है कि वह सूची किस चीज़ से बनी है। इसलिए हर संबंध अपनी प्रक्रिया दिखाता है, और वह एक विधि जिसके पास दिखाने को कुछ नहीं — विरासत में मिले परस्पर संदर्भ — यह बात साफ़ कहती है, बजाय उन चार से विश्वसनीयता उधार लेने के जिनके पास दिखाने को है।
इसकी सीमाएँ, लिखित रूप में। यहाँ हर विधि का एक अंधा स्थान है, और हर एक को विधि के पन्ने पर उस चीज़ के साथ बताया गया है जो वह अच्छी तरह करती है। जो उपकरण केवल यह प्रचार करता है कि वह क्या कर सकता है, वह आपको उस पर ज़रूरत से ज़्यादा भरोसा करना सिखाता है।
ऊपर की खोज-पट्टी क्या कर सकती है
ऊपर की पट्टी दो अलग काम करती है, और कौन-सा, यह इस पर निर्भर करता है कि आप क्या टाइप करते हैं।
एक संदर्भ टाइप कीजिए — यूह 3:16, उत्प 1, भजन 23 — और वह सीधे वहाँ ले जाती है। संक्षिप्त रूप चलते हैं, बड़े-छोटे अक्षरों से फ़र्क नहीं पड़ता, और पद-संख्या के बिना अध्याय पद 1 पर खुलता है।
कुछ और टाइप कीजिए, तो वह एक खोज है, जिसका उत्तर संबंधों की सूची की जगह दाईं ओर के स्तंभ में लिखा जाता है। उस स्तंभ के ऊपर मिले पदों की संख्या और वापस जाने का एक बटन होता है। यह उस अनुवाद के किसी शब्द के लिए काम करता है जिसे आप पढ़ रहे हैं (चरवाहा, यदि आप IRV पढ़ रहे हैं), किसी यूनानी शब्द (ἀγάπη) के लिए, और किसी Strong संख्या (H7225, G26) के लिए।
एक चीज़ जो पट्टी नहीं कर सकती, वह है इब्रानी शब्द की खोज। इब्रानी पक्ष पर वह एक ऐसी सूची में खोजती है जिसमें इब्रानी शब्द नहीं, बल्कि Strong संख्याएँ हैं, इसलिए ראשית हमेशा खाली लौटेगा। इब्रानी के लिए संख्या है — H7225 काम करता है — या मूल पाठ में खोजें टैब, जो स्वयं शब्दों में खोजता है और उन्हें उनके व्याकरण के अनुसार छाँट भी सकता है।
छोटी स्क्रीन पर वह दाईं ओर का स्तंभ पाठ के बगल में नहीं, बल्कि उसके नीचे होता है। तब पन्ना स्वयं परिणामों को सामने ले आता है, ताकि आप शून्य में टाइप न कर रहे हों।
सभी पुस्तकें एक स्क्रीन पर
खोज-क्षेत्र के बगल में एक पुस्तकें बटन है। वह सभी छियासठ पुस्तकें एक साथ स्क्रीन पर रखता है, धर्मशास्त्र-संग्रह के क्रम में, पुराने और नए नियम को अलग रंगों में। एक पुस्तक चुनिए, फिर एक अध्याय, फिर एक पद: कहीं से भी कहीं तक तीन टैप, बिना टाइप किए। शॉर्टकट b है, और Esc उसे फिर बंद कर देता है।
यह किसी पद तक पहुँचने का तीसरा रास्ता है, खोज-क्षेत्र के अलावा — जो खुले शब्दों की तरह ही आसानी से संदर्भ भी लेता है — और बगल के स्तंभ के अलावा, जहाँ तीर वाली कुंजियाँ आपको पद-दर-पद आगे ले जाती हैं।
इसका उपयोग कैसे करें
किसी ऐसे पद से शुरू कीजिए जिसे आप पहले से अच्छी तरह जानते हैं। देखिए कि पाँचों विधियाँ उसके लिए क्या लौटाती हैं और, इससे भी उपयोगी, वे कहाँ असहमत हैं। स्वतंत्र विधियों के बीच सहमति पूरी प्रणाली का सबसे प्रबल संकेत है; केवल एक विधि से मिला संबंध एक प्रश्न है, उत्तर नहीं।
जब कुछ रखने योग्य हो, तो उसे एक टिप्पणी के साथ संग्रह में डालिए, और उस संग्रह को एक फ़ाइल के रूप में वहीं सहेजिए जहाँ आप लिख रहे हैं।
विश्लेषण का नाम Moria क्यों है
मोरिय्याह वह स्थान है जहाँ अब्राहम को देखने के लिए भेजा गया, और जहाँ उसने पाया कि जो उससे कहा गया था और जो उसे दिखाया गया, वे तब तक एक नहीं थे जब तक वह जाकर देख न ले। यह नाम याद दिलाता है कि अध्ययन का काम जाना और देखना है। यह नाम विश्लेषण का है, इस साइट का नहीं।